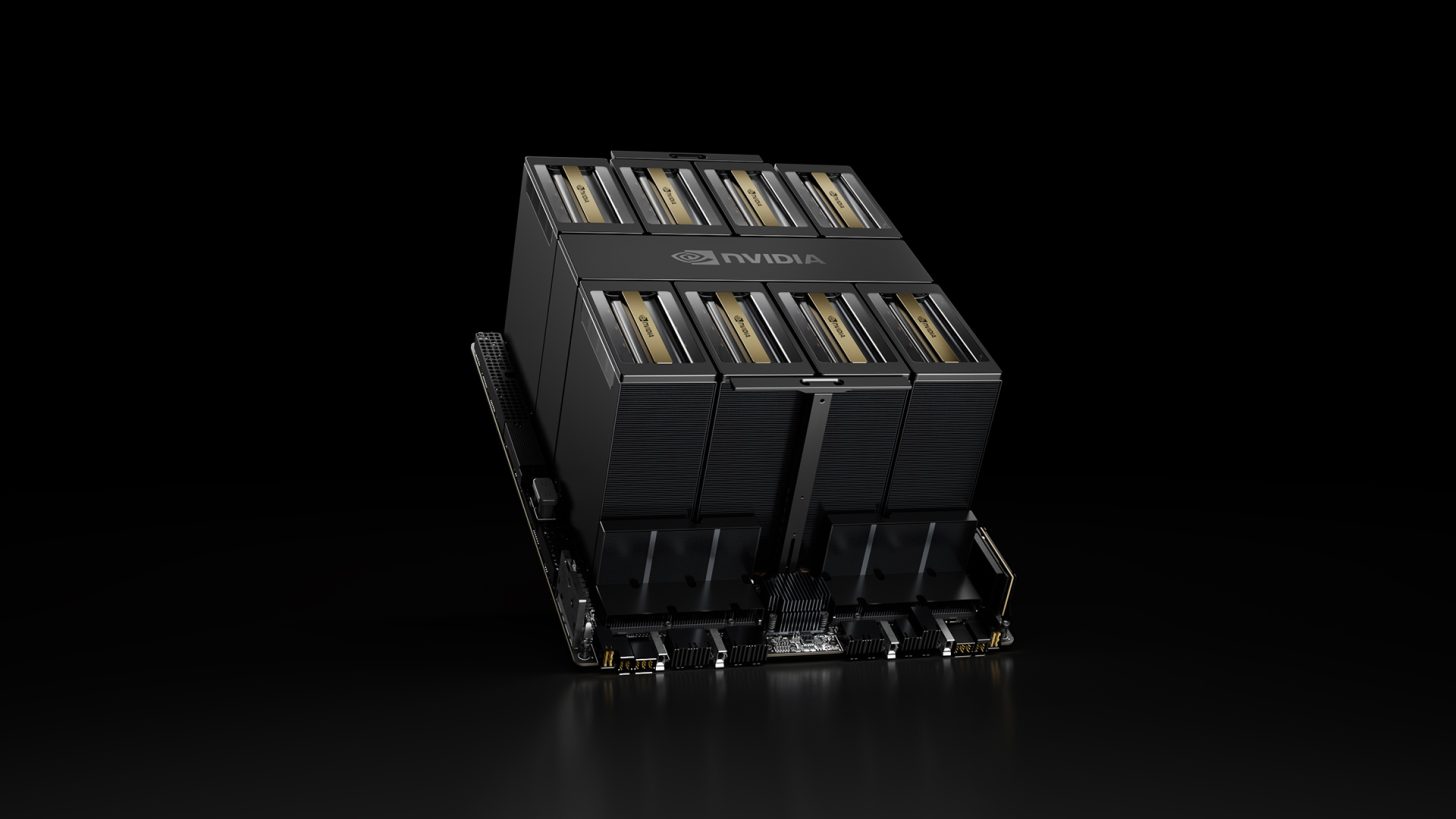
Az NVIDIA Vera Rubin NVL72 platform első alkalommal szerepelt az MLPerf Inference v6.1 tesztsorozatban, és már debütálásakor kiemelkedő eredményeket produkált: a Qwen3-VL modellen akár 3,7-szeres, a DeepSeek-R1 modellen pedig akár 2,5-szeres áteresztőképességet mutatott a korábbi GB300 NVL72 rendszerhez képest. A 2026. szeptember 16-án publikált eredmények egyben azt is megmutatják, hogyan épül fel az NVIDIA teljes AI-infrastruktúra-stratégiája a hardveres, szoftveres és hálózati optimalizáció egységes rendszerébe.
A Vera Rubin NVL72 MLPerf-debütje: mit mutatnak a számok?
Az NVIDIA a v6.1-es MLPerf Inference tesztsorozat Closed Division kategóriájában két különösen igényes benchmarkon indította el a Vera Rubin NVL72 előzetes (preview) eredményeit: a DeepSeek-R1 és a Qwen3-VL modelleken. Az eredmények az mlcommons.org oldalon 2026. szeptember 16-án kerültek közzétételre (bejegyzések: 6.1-0106 és 6.1-0074).
- Qwen3-VL: a Vera Rubin NVL72 akár 3,7-szeres áteresztőképességet ért el a GB300 NVL72-höz képest offline, szerver és interaktív forgatókönyvekben egyaránt, a vLLM keretrendszert és az NVIDIA Dynamo nyílt forráskódú inferencia-keretrendszert használva.
- DeepSeek-R1: az NVIDIA TensorRT-LLM könyvtárral a Vera Rubin NVL72 akár 2,5-szeres áteresztőképességet produkált a GB300 NVL72-höz képest.
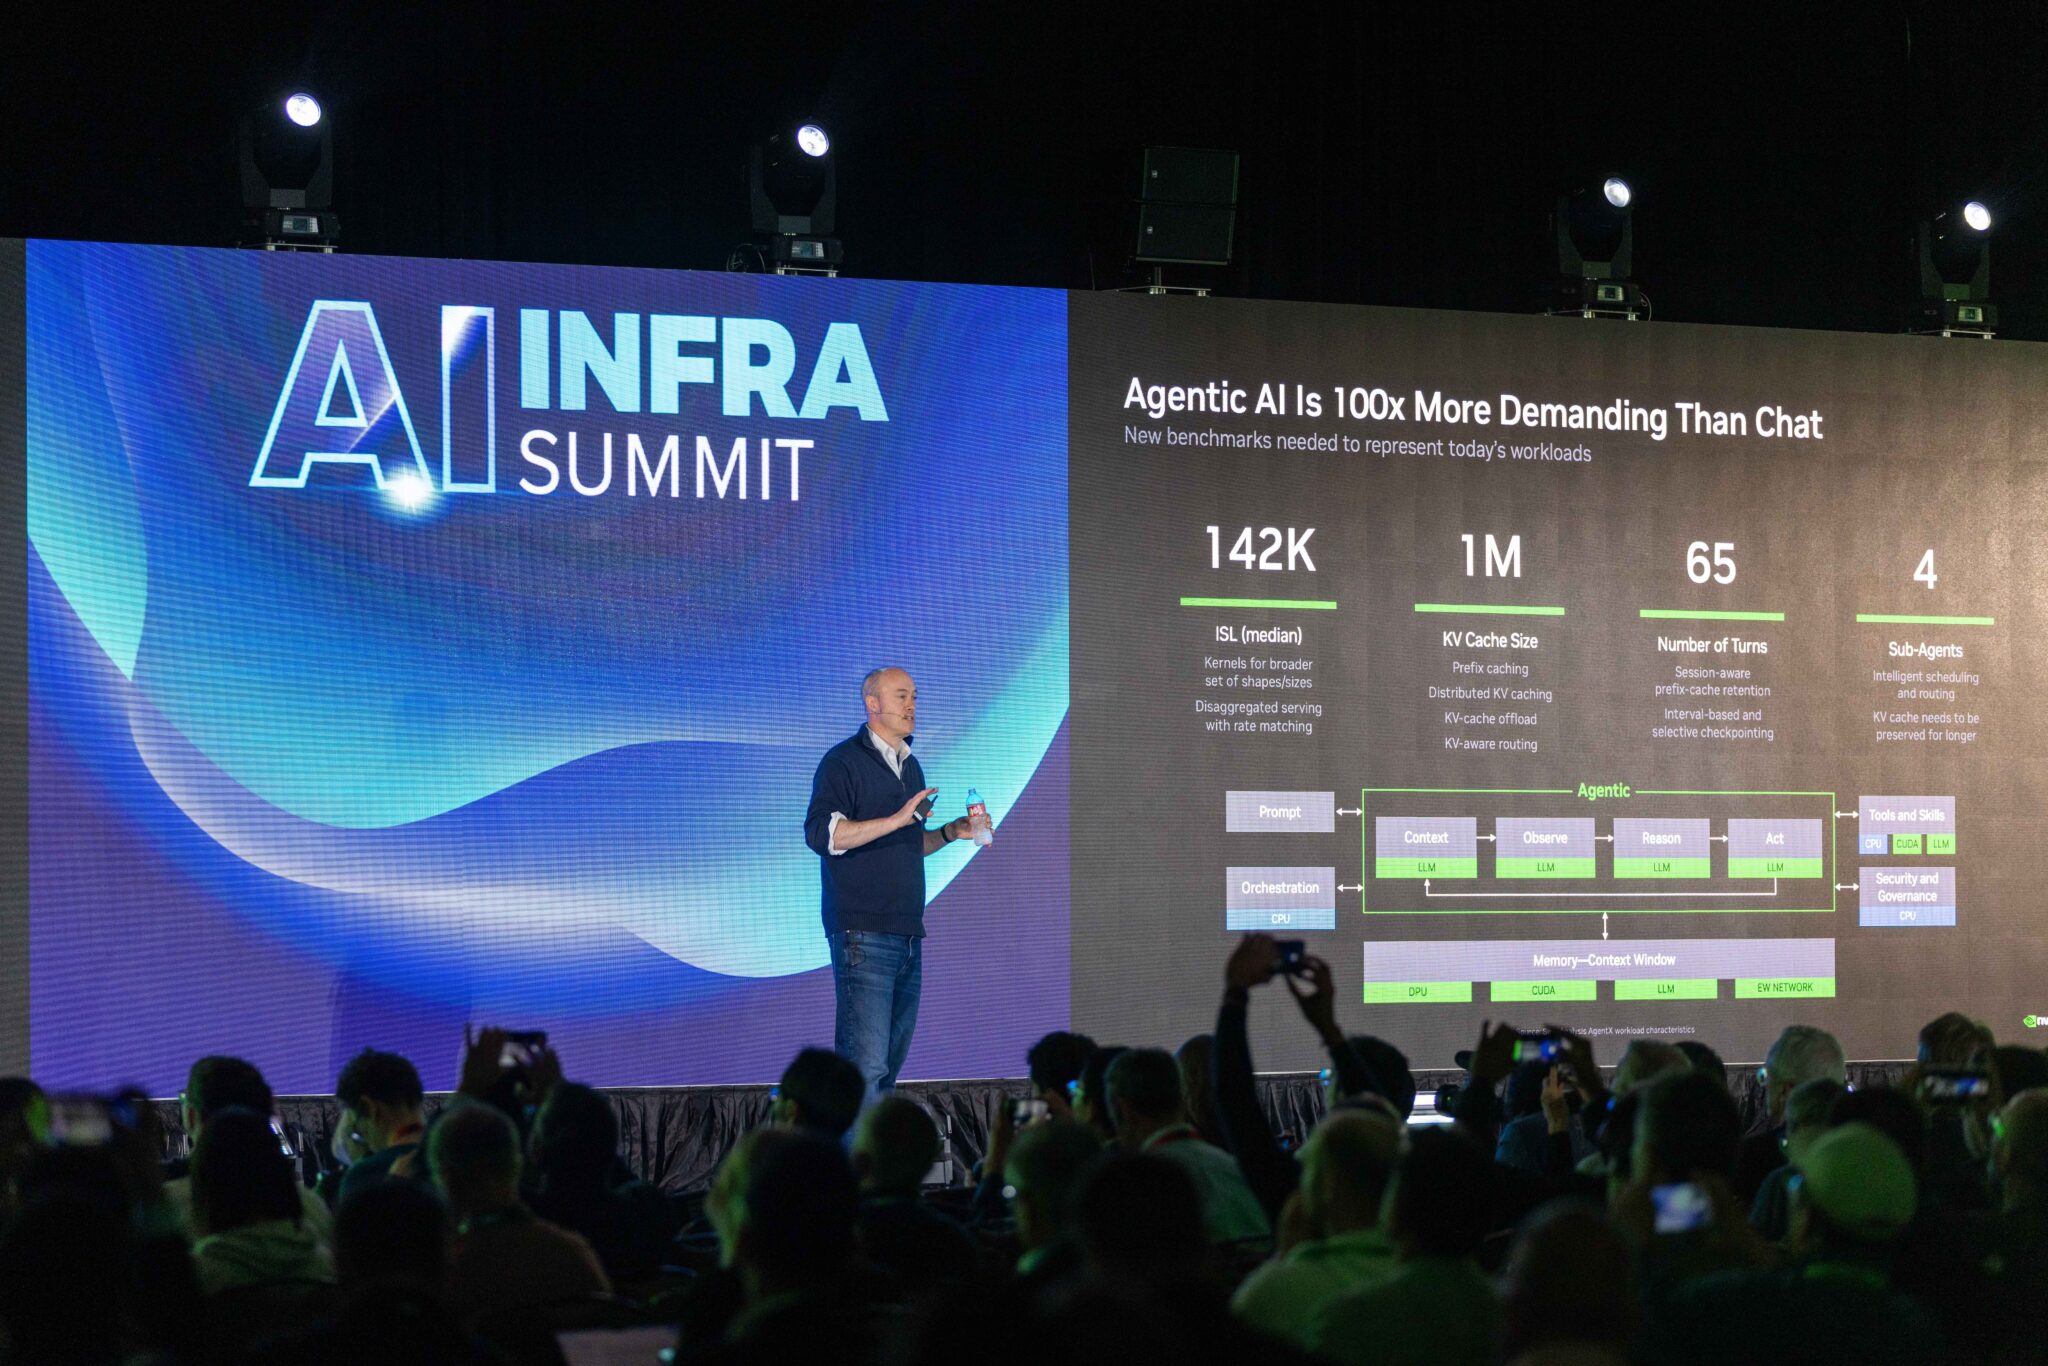
- Agentic AI benchmark (SemiAnalysis AgentX): előzetes tesztelésben a Vera Rubin NVL72 30-szoros teljesítményt nyújtott a GB300 NVL72-höz képest az ágenstípusú AI-feladatokon.
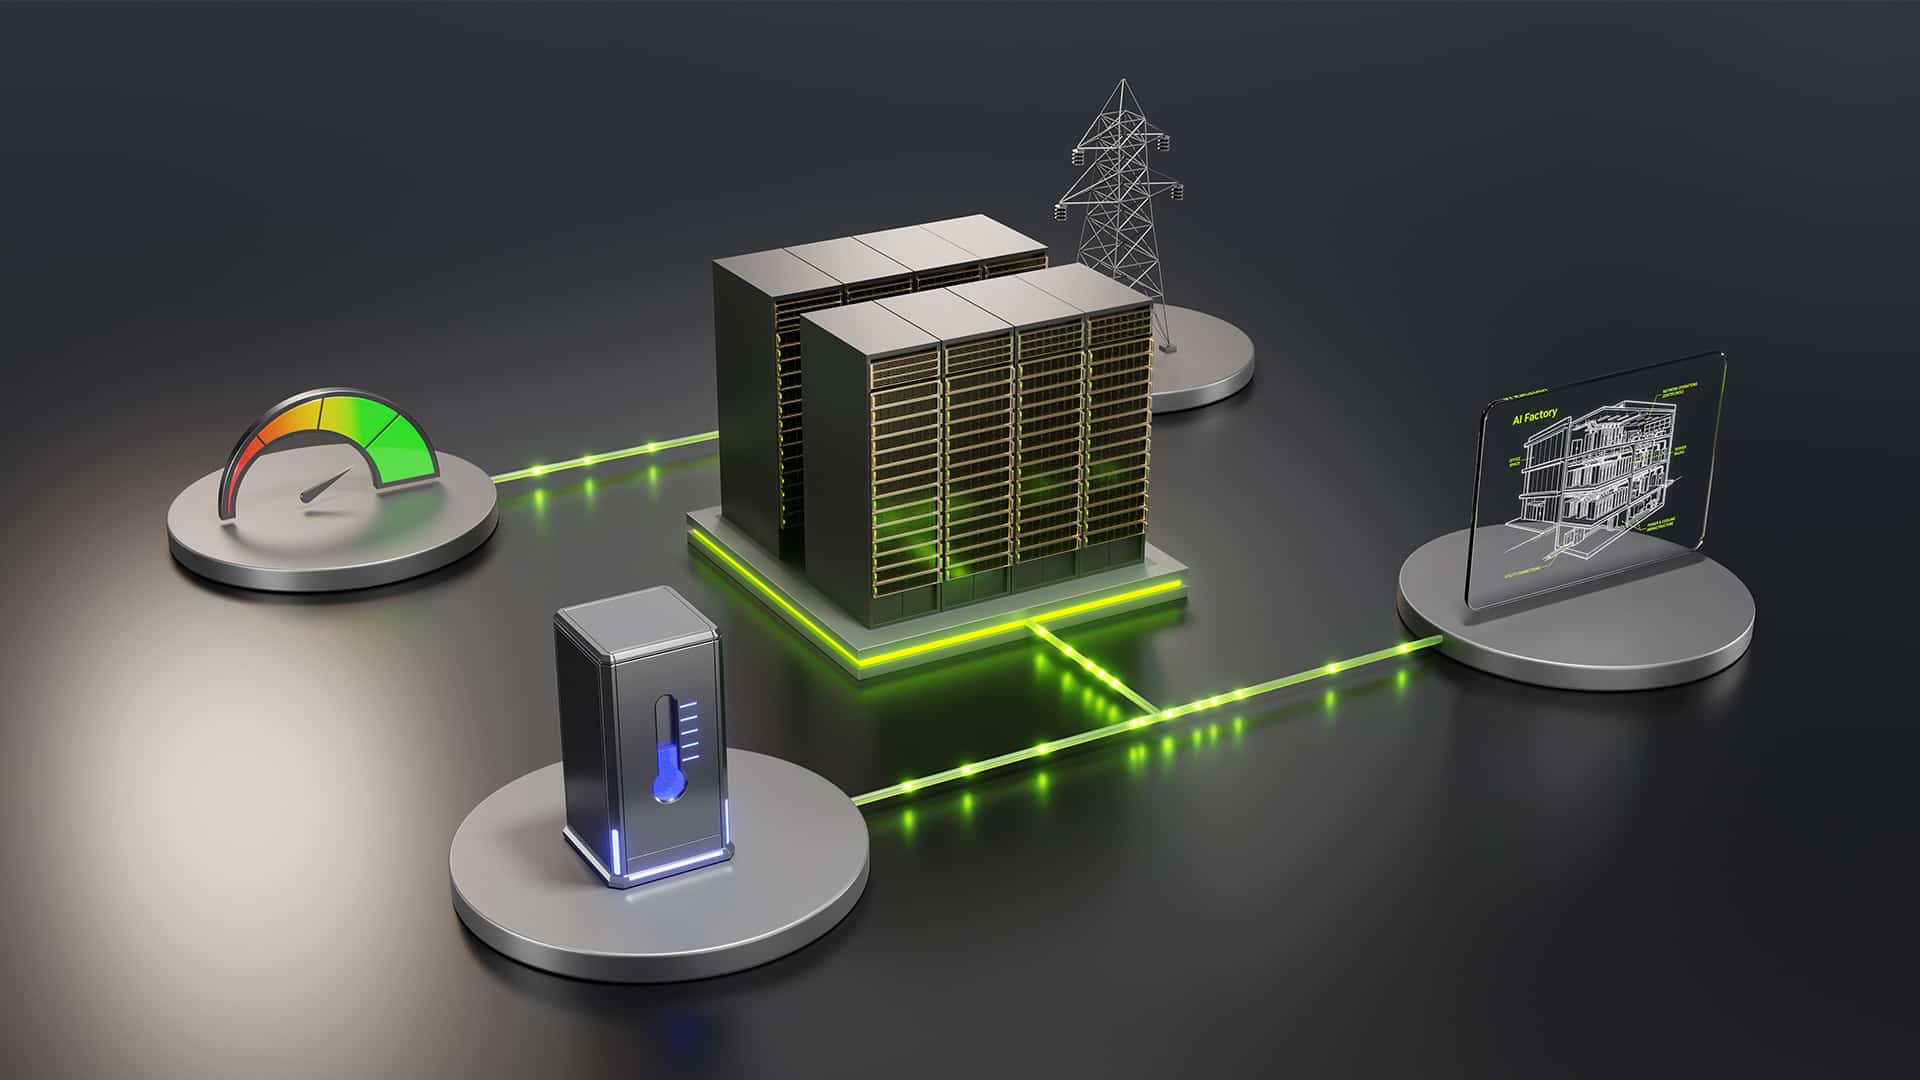
A magasabb áteresztőképesség közvetlen üzleti következménnyel jár: egyetlen Vera Rubin NVL72 rack több tokent generál, több felhasználót képes kiszolgálni, és alacsonyabb az egy tokenre jutó költség, mint egy GB300 NVL72 rack esetén. Ez az NVIDIA AI-infrastruktúra hatékonyságnövelési törekvéseibe is illeszkedik, amelynek keretében a vállalat folyamatosan optimalizálja a teljesítmény és az energiafelhasználás arányát.
Vera Rubin NVL72: a teljes hardver-szoftver kodesign mögött
A kiemelkedő eredmények hátterében az NVIDIA által „full-stack codesign”-nak nevezett megközelítés áll, amely a hardver és a szoftver együttes tervezését jelenti. A Vera Rubin platform főbb műszaki jellemzői:
- Fejlesztett Tensor Core-ok és Transformer Engine: mind az inferencia prefill (előkészítő), mind a decode (dekódoló) fázisát gyorsítják.
- NVFP4 precizitás: csökkenti a memóriaigényt a modellsúlyok, az attention mechanizmus és a KV cache esetében, miközben az eredmény minősége minimálisan romlik, az áteresztőképesség viszont nő.
- Disaggregated serving (szétválasztott kiszolgálás): a prefill és decode fázisok elkülönített kezelése, nagy léptékű expert párhuzamossággal a mixture-of-experts rétegekhez – ez különösen hatékony olyan modellekben, mint a DeepSeek-R1 és a Qwen3-VL.
- Hatodik generációs NVIDIA NVLink és NVLink Switch: a NVL72 skálázási tartományában 10-szeres csomagátviteli sebességet és 3-szoros kisebb késleltetést biztosít a sima Ethernethez képest.
A NVLink-alapú rack-szintű összeköttetés lehetővé teszi, hogy ezek a technikák rack-szinten is hatékonyan működjenek. A Nebius is benyújtott Vera Rubin NVL72 előzetes eredményeket, és szintén kiváló teljesítményt mutatott.
GB300 NVL72: 99%-os skálázási hatékonyság négy rack felett
A Vera Rubin mellett az NVIDIA a GB300 NVL72 rendszer skálázási hatékonyságát is demonstrálta. A DeepSeek-R1 benchmarkon egyetlen GB300 NVL72 rack (72 GPU) eredményét hasonlították össze négy összefűzött rack (288 GPU) teljesítményével.
- A négy rack konfigurációja 99%-os skálázási hatékonyságot ért el az offline forgatókönyvben: az áteresztőképesség majdnem arányosan nőtt a hozzáadott hardverrel (bejegyzések: 6.1-0073 és 6.1-0074).
- A WAN 2.2 szöveg-videó benchmarkon a GB300 NVL72 egyetlen csomóponthoz képest 9-szeres áteresztőképességet és 7,5-szeres kisebb késleltetést ért el rack-szinten, 0,65 darab 720p videót generálva másodpercenként, videónként 5,7 másodperc alatt.
A skálázási hatékonyság azért kulcsfontosságú, mert a GPU-szám növelése önmagában nem garantálja az arányos teljesítménynövekedést. Ha kétszer annyi GPU csupán egyszámjegyű százalékos javulást hozna, az infrastruktúra-költség messze meghaladná a teljesítmény-hozamot.
Szoftveroptimalizáció és ökoszisztéma: folyamatos fejlődés
Az NVIDIA hangsúlyozza, hogy a platform értékét nem csak a hardver, hanem a folyamatos szoftverfejlesztés is növeli. A v6.1-es eredmények a v6.0-hoz képest akár 1,6-szoros teljesítményjavulást mutatnak a GB300 NVL72 Qwen3-VL benchmarkján. Az elért nyereség forrásai:
- Alacsonyabb KV cache precizitás
- További kernel fúzió
- Fejlettebb kernelek
- Szétválasztott kiszolgálás vLLM-mel és NVIDIA Dynamo-val
A v6.1-es benyújtási határidő után is folytatódtak az optimalizációk. A GPT-OSS-120B és DLRMv3 modelleken elért post-submission eredmények – amelyeket az MLCommons még nem hitelesített – további teljesítménynyereséget mutatnak.
Az NVIDIA ökoszisztéma-partnerei széleskörűen részt vettek a tesztsorozatban: összesen 19 partner nyújtott be eredményeket, köztük nyolc multi-node Blackwell NVL72 rendszereken. A résztvevők között szerepel az ASUS, az Azure, a Cisco, a CoreWeave, a Crusoe, a Dell Technologies, a Fujitsu, a Giga Computing, a HPE, az Inventec, a Lambda, a MiTAC Computing, a Nebius, az Oracle Cloud Infrastructure, a Quanta Cloud Technology, a Red Hat, a ScitiX, a Supermicro és a Wiwynn.
Az edge-eszközök oldalán az NVIDIA a Jetson AGX Thor platformon is benyújtott eredményeket az újonnan bevezetett Edge-Agentic benchmarkon, NVIDIA TensorRT Edge-LLM-et alkalmazva a Qwen3.6-27B modellel. Az NVIDIA célja tehát, hogy a kompakt peremhálózati eszközöktől a legnagyobb AI-gyárakig egyaránt vezető teljesítményt kínáljon – amit az ipari és közlekedési alkalmazások területén is egyre inkább kamatoztatni kívánnak.
Gyakori kérdések
Melyik modelleken tesztelte az NVIDIA a Vera Rubin NVL72-t az MLPerf v6.1-ben?
Az NVIDIA két benchmark-on indított előzetes (preview) eredményeket: a DeepSeek-R1 és a Qwen3-VL modelleken, mindkettő az MLPerf Inference v6.1 Closed Division kategóriájában szerepel.
Mit jelent a 99%-os skálázási hatékonyság a GB300 NVL72 esetén?
Azt jelenti, hogy négy GB300 NVL72 rack (288 GPU) összekapcsolásakor az áteresztőképesség majdnem pontosan arányosan nőtt a hozzáadott hardverhez képest – vagyis a GPU-kapacitás bővítése szinte teljesen hasznosul, nem vész el a koordinációs veszteségekben.
Miért releváns az agentic AI teljesítménye az MLPerf összefüggésében?
Az AI ágensek több lépésen át gondolkodnak, terveznek és cselekednek, ami eltérő mérési módszertant igényel a hagyományos áteresztőképességi benchmarkoktól. Az MLCommons hamarosan bevezeti az MLPerf Endpoints benchmarkot, amely már standardizált mérést kínál az agentic inferencia-terhelésekre.
Milyen szoftvereszközöket használt az NVIDIA a Vera Rubin teszteléséhez?
A Qwen3-VL benchmarkon a vLLM keretrendszert és az NVIDIA Dynamo nyílt forráskódú inferencia-keretrendszert alkalmazták, míg a DeepSeek-R1 teszteléséhez az NVIDIA TensorRT-LLM könyvtárat használták.
Forrás: NVIDIA Blog