Az idei AI Infra Summit – amelyet sokan az infrastruktúra-technológia Coachellájának emlegetnek – rekordot döntött: a Santa Clara Convention Centerben idén több mint 8000 résztvevő jelent meg, szemben a tavalyi 3500-zal. Az NVIDIA Ian Buck alelnök vezette előadássorozata a legfontosabb üzenetet hordozta: az AI-gyárak hatékonyságát immár nem a csúcsteljesítmény, hanem a megawattonként generált tokenek száma alapján mérik, és ezen a téren az NVIDIA Vera Rubin, a DSX platform és a Groq 3 LPX együttesen új szintet hoznak.
NVIDIA Vera Rubin és DSX: a teljes verem logikája
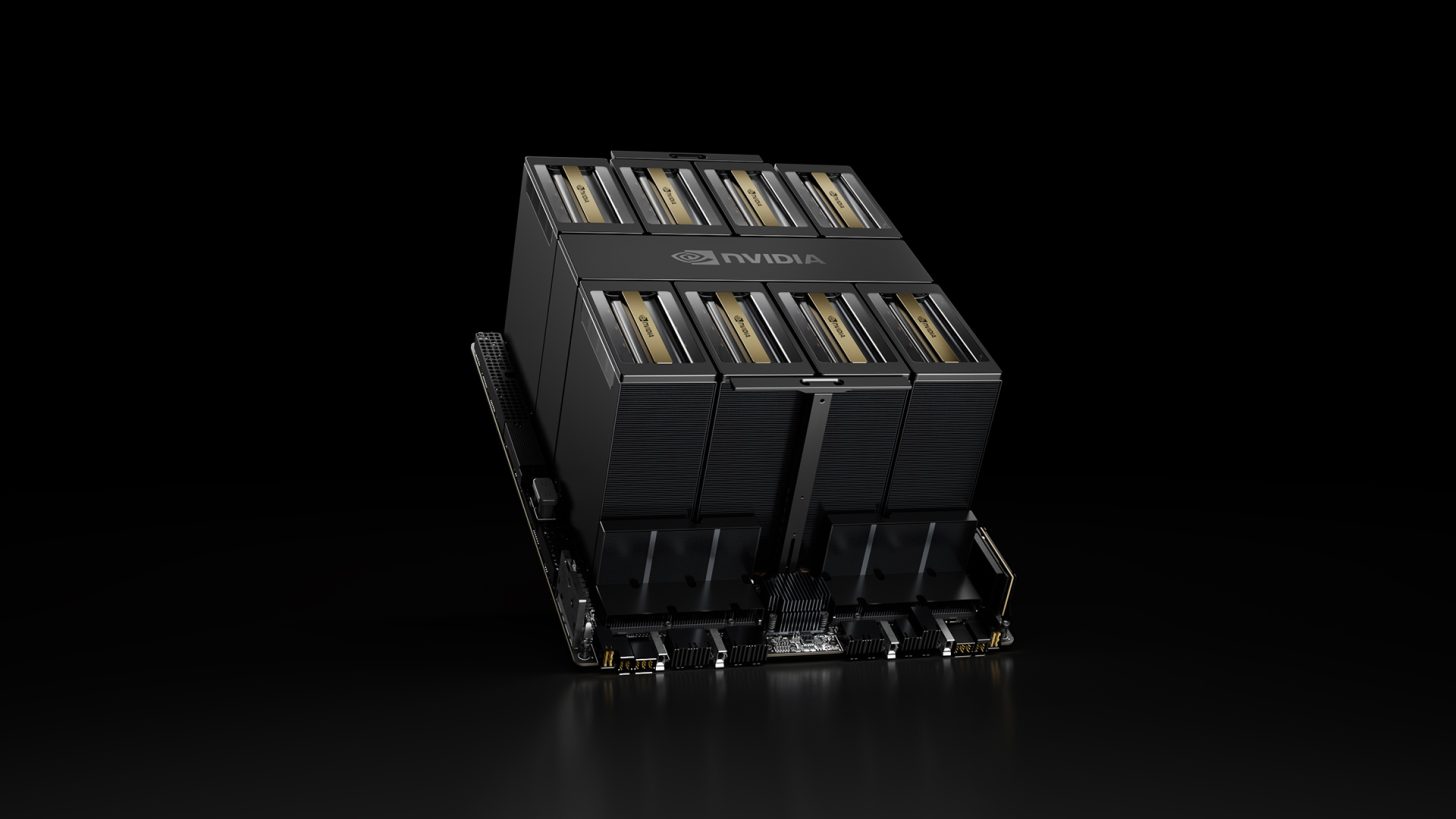
Ian Buck az NVIDIA hyperscale és nagy teljesítményű számítástechnikáért felelős alelnöke hangsúlyozta: az AI-infrastruktúrát ma már szilíciumtól az elektromos hálózatig kell tervezni. Az NVIDIA erre a kihívásra egy teljes platformveremmel válaszol, amelynek elemei:
- Vera Rubin NVL72 rendszerek – a következő generációs AI-infrastruktúra alapja
- Dynamo következtetési szoftver
- NeMo könyvtárak modellezéshez és finomhangoláshoz
- NVLink a nagy léptékű gyorsítószámítás összekötéséhez
- Spectrum-X Ethernet és ConnectX SuperNIC-ek ezrek csomópontjainak összekapcsolásához
- BlueField alapú kontextus-memória-tárolás és DPU-k infrastruktúra-biztonsági feladatokhoz
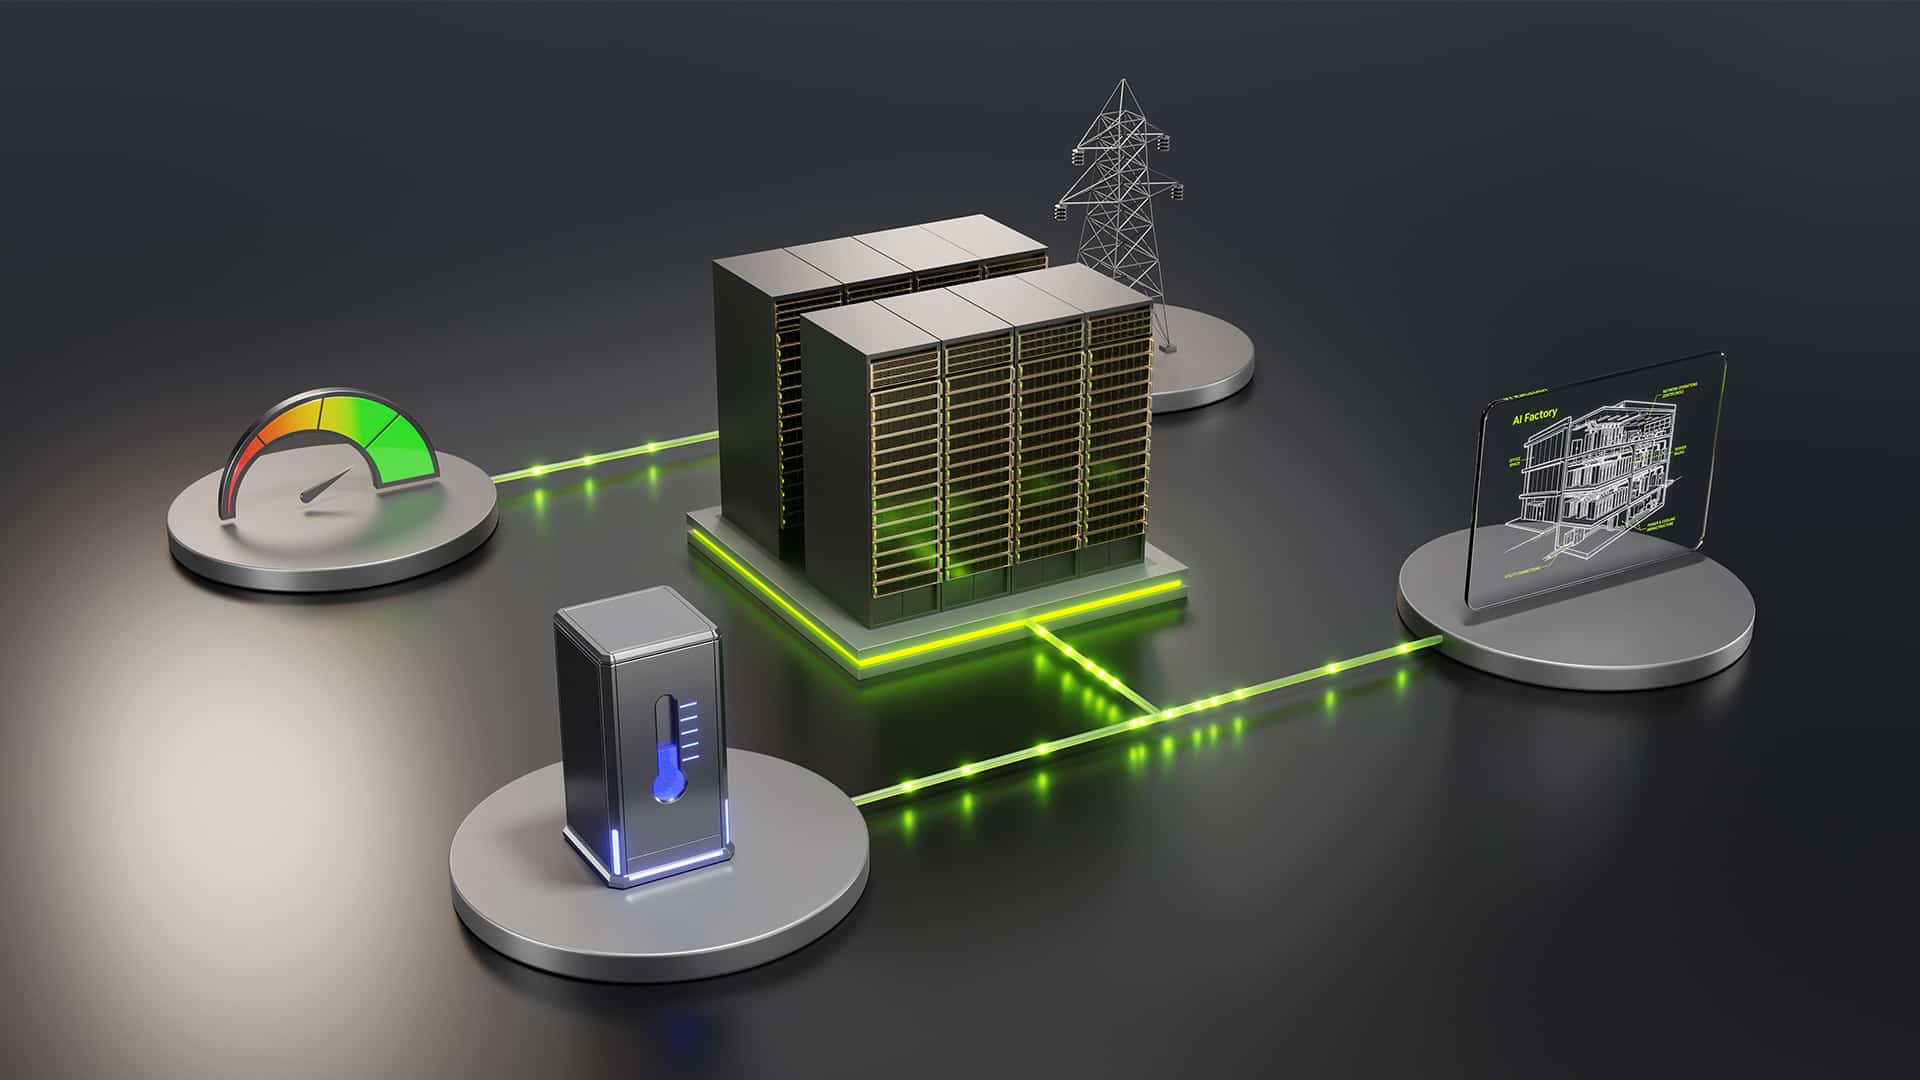
Buck szerint az így felépített infrastruktúra „fungibilis, megbízható és 10 évre szóló eszköz”, amellyel az iparágak legfontosabb számítási problémái megoldhatók. Az NVIDIA DSX MaxLPS – az egész gyárra kiterjedő teljesítményoptimalizálási megoldás – a forrás adatai szerint az egyébként statikus kiosztás miatt kihasználatlanul maradó kapacitást visszanyeri: megawattonként akár 1,4-szeres tokenmennyiséget tesz lehetővé.
Lambda és a DSX MaxLPS: 24%-kal több token ugyanannyi áramból
Az AI felhőszolgáltató Lambda az AI Infra Summiten mutatta be a DSX MaxLPS első, Blackwell-szervereken végzett validált eredményeit. A rendszer folyamatosan figyeli a GPU-k és rackek energiafogyasztását, és dinamikusan tolja át az elérhető teljesítményt oda, ahol épp szükség van rá – ahelyett, hogy statikusan előre osztaná ki azt. Mivel a tanítási és következtetési munkaterhelések eltérő teljesítményprofilokkal rendelkeznek, a MaxLPS vegyes munkaterhelésű AI-gyárakban is képes optimalizálni az elosztást.
A mért eredmények figyelemre méltók:
- 19 csomópontot futtattak azon az energiakereten belül, amelyet általában 16 teljes teljesítményű csomóponthoz szoktak allokálni
- A klaszteres token-áteresztőképesség 24%-kal nőtt – hozzávetőleg 4 millióról 5 millió tokenre másodpercenként
- A wattankénti teljesítmény 23%-kal javult
A következő generációs Vera Rubin NVL72 AI-gyáraknál a DSX MaxLPS a megfelelő telepítési környezetben akár 40%-kal több GPU-kapacitást tesz lehetővé ugyanazon megawattos kereten belül – ami azt jelenti, hogy az üzemeltetők új áramvezetékek nélkül növelhetik AI-kapacitásukat.
Vera Rubin NVL72 és Groq 3 LPX: extrém hatékonyság ügynöki AI-hoz
Az ügynöki (agentic) AI egy különleges kihívást jelent: az ügynökök egymásra épülő gondolkodási lépései és eszközhívásai miatt a késleltetés és a kontextusmélység gyorsan összeadódik. Erre az NVIDIA a Groq 3 LPX integrációjával válaszol, amely determinisztikus, ultraalacsony késleltetésű következtetést ad a Vera Rubin platformhoz. A két rendszer kombinálva:
- Akár 35-szörös token-áteresztőképességet kínál megawattonként a GB200 NVL72-höz képest, 2 billió paramétert meghaladó modelleken, hosszú kontextusban
- Egy 100K kontextusú Qwen 3.8 27B munkaterhelésen a Groq 3 LPX 2529 kimeneti tokent generált másodpercenként felhasználónként
- Az Intelligent Power Smoothing szoftver és a bővített energiapufferek elnyelik a rövid teljesítménytüskéket, így a rendszerek fenntartható igény közelében futhatnak
Ezen felül a rackszintű gyártóterületen belül is megszünik az úgynevezett „elszórt fejléc” probléma: az eddig kihasználatlan kapacitás produktív számítási erőforrássá alakul, ami factory-szinten akár 35%-kal magasabb token-áteresztőképességet eredményez új áramvezetékek nélkül. Az AI Infra Summit 2026 más nagy szereplői, köztük az Intel is hasonló hatékonysági megközelítéseket képviseltek az eseményen.
Partneri együttműködések és rugalmas hálózati terheléskezelés
Az NVIDIA az AI Infra Summiten számos fontos partnerséget is bejelentett, amelyek az egész AI-ökoszisztémát érintik:
- Amazon Annapurna Labs az NVIDIA NVHBM egyedi nagy sávszélességű memóriatechnológián dolgozik együtt az NVIDIA-val
- d-Matrix a NVLink Fusion integrációján keresztül az NVIDIA Vera CPU-kat ötvözi a d-Matrix Raptor XPU-kkal, hogy ultraalacsony késleltetésű következtetést nyújtson nagy léptékben – erről bővebben a d-Matrix NVLink Fusion cikkünkben írtunk
- Pinterest az NVIDIA Blackwell platformot és a Dynamo következtetési szoftvert használja, hogy társalgási AI-t hozzon létre vizuális felfedező funkciójához
- Emerald AI és az NVIDIA a Silicon Valley Power közreműködésével bemutatta a kereskedelmi AI-gyári rugalmas terhelésprogram működését
Ez utóbbi különösen figyelemre méltó: a Silicon Valley Power rugalmas terhelés-összekapcsolási programja lehetővé teszi, hogy az AI-gyárak aktívan támogassák a hálózat kiegyensúlyozását. Az Emerald AI rendszere sikeresen reagált a Silicon Valley Power több száz keresleti jelzésére úgy, hogy közben az AI munkaterhelések teljesítménye nem csökkent. A DSX Flex szoftver automatikusan képes fogadni a hálózati jelzéseket – terheléscsökkentési kérelmeket, keresletválasz-eseményeket és árjelzéseket –, majd egy előre definiált munkaterhelés-hierarchia alapján önállóan dönt: a kritikus feladatok futnak tovább, míg az alacsonyabb prioritásúak átmenetileg szünetelnek, majd folytatódnak. Az DSX platform részleteit korábban már bemutattuk.
Vera Rubin NVL72 MLPerf-eredmények: 3,7-szeres áteresztőképesség
Az eseményen az MLPerf Inference v6.1 legújabb eredményeit is ismertették. Az MLCommons konzorcium iparági benchmarksorozatában – ahol minden eredmény szakértői felülvizsgálaton esik át – a Vera Rubin NVL72 első előzetes beadványában akár 3,7-szeres áteresztőképességet ért el az NVIDIA GB300 NVL72-höz képest.
A GB300 NVL72 skálázhatósága szintén kiemelkedő: egy négy GB300 NVL72 rackre kiterjedő, 288 GPU-s beadvány 99%-os skálázási hatékonyságot mutatott, azaz az áteresztőképesség szinte lineárisan nőtt az egyetlen rackből induló alapállapothoz képest. Ráadásul pusztán szoftveroptimalizációkkal – hardvercsere nélkül – az NVIDIA MLPerf Inference v6.1-es beadványai akár 1,6-szoros teljesítménynövekedést értek el a v6.0-hoz képest, a beadási időszak után pedig további javulást mértek.
Gyakori kérdések
Mit jelent a „tokenek megawattonként” mérőszám az AI-gyárak esetében?
Ez az új iparági metrika azt méri, hogy egy AI-gyár mennyi szöveges kimenetet (tokent) képes előállítani egységnyi elektromos energia felhasználásával. A csúcsteljesítmény helyett egyre inkább ez határozza meg az AI-infrastruktúra valódi gazdasági értékét és fenntarthatóságát.
Hogyan működik a DSX MaxLPS a gyakorlatban?
A DSX MaxLPS folyamatosan figyeli az összes GPU és rack energiafogyasztását, majd dinamikusan átcsoportosítja a rendelkezésre álló teljesítményt a pillanatnyi igény szerint. Ezáltal a statikus kiosztás miatt eddig kihasználatlan kapacitás produktív számítási erőforrássá válik, a Lambda tesztjei szerint akár 24%-kal több tokent generálva ugyanazon energiakereten belül.
Mi a DSX Flex rugalmas terhelésprogram lényege?
A DSX Flex lehetővé teszi, hogy az AI-gyárak valós idejű hálózati jelzések alapján automatikusan csökkentsék energiafogyasztásukat. A rendszer egy előre meghatározott prioritási hierarchia szerint dönti el, melyik feladat fut tovább és melyik szünetel átmenetileg – így az AI-létesítmények aktív rugalmas erőforrásként segíthetik az elektromos hálózat kiegyensúlyozását.
Milyen valós munkaterhelésen mérték a Groq 3 LPX teljesítményét?
A forrás szerint egy 100 000 tokenes kontextusú Qwen 3.8 27B modell munkaterhelésen a Groq 3 LPX felhasználónként 2529 kimeneti tokent generált másodpercenként, ami ügynöki AI-feladatoknál – ahol a gondolkodási lépések és eszközhívások egymásra épülnek – különösen fontos előny.
Forrás: NVIDIA Blog